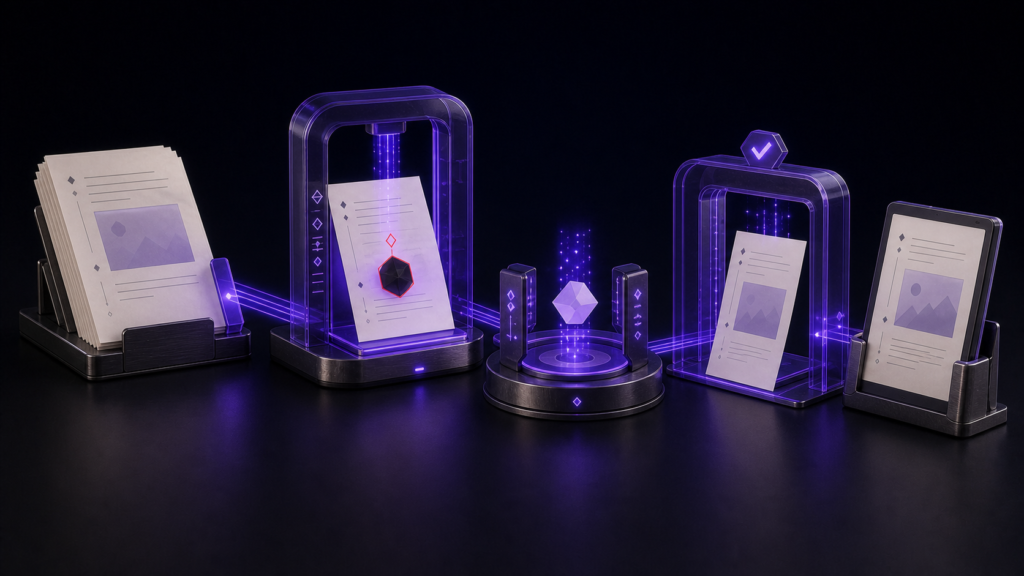
EPUB原稿の外字で保存事故を防ぐには、「外字らしく見える文字」を一括置換せず、選択した文字コードで表現できない文字だけを位置付きで列挙し、承認した代替だけを別名ファイルへ反映します。
今回の1,000字標本は私用領域文字2件、絵文字1件、異体字候補2件を想定しましたが、実測でShift_JIS変換不能として列挙されたのはインデックス18の😀1件だけでした。代替後は0件になり、UTF-8版とShift_JIS版を再読込した本文は一致しました。残る4候補の分類を実測値で証明できていないため、全体判定はpartialです。
外字候補と変換不能文字を同じにしない
外字は用途や環境によって意味が広く、私用領域文字、機種依存文字、異体字、選択文字コードで表現できないUnicode文字が同じ集合になるとは限りません。保存事故の判断に使うのは、今回保存する文字コードで変換できるかどうかです。
一般的な手順では、候補を「残す」「代替する」「対象外」に分類します。読みや固有名詞を変える可能性があるため、変換不能だからという理由だけで一括置換しません。
分類表には、文字そのもの、出現位置、周辺語、採用する代替、承認者を残します。同じ字形に見えても文脈上の役割が違えば、別の判断として扱います。
1,000字標本の候補を位置付きで確認する
原本を上書きせず、1,000字の複製を使います。想定した候補は私用領域文字2件、絵文字1件、異体字候補2件です。文字コード、改行、文字数を開始値として記録し、Shift_JISへ保存する前に変換不能位置を取得します。
検出結果が想定5件でなくても、数を合わせるために候補を追加しません。検出された文字、位置、理由をそのまま記録し、未検出候補は未確認として残します。
承認した1件だけを代替して別名保存する
Stage 4では、変換不能として検出された😀(インデックス18)を承認済み代替へ変更しました。原本ではなく、UTF-8別名版とShift_JIS別名版を作ります。保存後は両方を閉じて再読込し、修正後本文が一致するかを確認します。
この操作の中心は「外字を全部消す」ことではなく、検出1件と承認1件を対応させることです。異体字候補や私用領域文字が検出されなかった理由は、今回の証拠だけでは決めません。
実測値は1件検出、代替後0件、再読込一致
タイトル固有のStage 4は3操作で、要求文字数1,000、実文字数1,000、変換不能1件、位置18、文字😀でした。代替後は0件、UTF-8別名版はUTF-8、Shift_JIS別名版はShift_JIS、改行はLF、repaired_text_matches=trueです。
共通Stage 4の別検証では、同一文をUTF-8、Shift_JIS、EUC-JPで39字、UTF-16LE、UTF-16BEで40字として読み取り、すべてLFでした。作業タブの設定はUTF-8として再取得しました。これは5形式の判定結果で、外字候補5件の分類結果ではありません。
partialの理由と失敗時の戻し先
今回、Rune Studioの保存前警告、赤表示、誤復号の見た目、自動保存の停止・再開はCLIで確認できませんでした。また、想定した私用領域文字2件と異体字候補2件が、実際にどの文字として標本へ入り、どう分類されたかはresult_valuesに残っていません。
- 実文字数が1,000でない:標本作成へ戻る
- 検出位置と原文が合わない:文字コードを変えず検出へ戻る
- 代替が未承認:保存せず候補一覧へ戻る
- 再読込本文が一致しない:別名版を破棄し、承認代替の直前へ戻る
- 残る4候補の分類が必要:今回の1件を成功のまま残し、候補入り標本を再構築する
破損済みデータの完全復元、OCR、バイナリ修復は扱いません。
Rune Studioの公開機能と今回の結果
現行Mac版Rune Studioは主要な日本語文字コードを読み分け、選択中の文字コードで表現できないUnicode文字を赤い背景で示し、残っている間は自動保存を一時停止する機能を公開資料で確認できます。これはStage 3の製品範囲です。
今回のStage 4はCLIで位置、件数、別名ファイルの文字コード、再読込一致を確認しました。赤表示や自動保存の挙動を確認したとは書きません。
結論:検出1件だけを承認置換できた
EPUBの外字による保存事故を防ぐ要点は、候補名ではなく「選択文字コードで変換不能か」を位置付きで確認し、承認した文字だけを別名版へ反映することです。今回、😀1件を位置18で検出し、代替後0件、二つの別名版の再読込一致まで確認しました。
一方、想定した私用領域文字2件と異体字候補2件の分類は未確認です。よって1件の操作は確認済み、標本全体は部分合格とします。現行Mac版の範囲はRune Studioの商品ページで確認できます。