テキストエディタ 文字コードを調べているなら、先へ進む条件より先に、自動判定を開始情報とし、代表文字とバイト境界で確定するのが答えです。対象は髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本です。この記事ではBOM、判定表示、代表文字、別名保存、再読込同値を使って、『UTF-8、BOM付きUTF-8、Shift_JISの三標本を判定・別名保存・再読込できる』までの判断を組み立てます。壊れた原稿の復元や全文字コードの完全自動判定は扱わないという範囲には踏み込みません。
直接回答:自動判定を開始情報とし、代表文字とバイト境界で確定する
先へ進む条件より先に、自動判定を開始情報とし、代表文字とバイト境界で確定するのが答えです。完成条件は『UTF-8、BOM付きUTF-8、Shift_JISの三標本を判定・別名保存・再読込できる』です。
判断欄はBOM、判定表示、代表文字、別名保存、再読込同値です。『壊れた原稿の復元や全文字コードの完全自動判定は扱わない』は合格条件へ混ぜません。
壊さないための停止線を先に引く
自動判定の表示だけを信じ、再読込後の本文を照合しないことという事故を避けるには、BOM・判定表示・代表文字・別名保存・再読込同値を開く前または変換前の確認欄にします。正本を直接触らず、戻せる複製と停止条件を用意してから始めます。
検査材料は髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本です。問題が見えた時点で先へ進まず、入力、操作、出力のどこで差が生じたかを分けます。二周目では、変更は一度に一項目だけに絞ります。
三標本の初期バイトを記録するから始める実行順
次の五項目は、髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本を同じ条件で扱うための製品非依存の検査順です。特定製品で確認した操作結果ではなく、どの候補にも適用する受け入れ手順として使います。各項目の終了時に、対象、BOMに関する確認事実、次の入力を一行ずつ残します。
一周目の終了条件は『UTF-8、BOM付きUTF-8、Shift_JISの三標本を判定・別名保存・再読込できる』を説明できることです。途中で判定名だけで本文を見ないなら、その地点で止めます。別の素材や設定へ逃げず、停止理由を同じ作業票へ書きます。
- 1. 三標本の初期バイトを記録する
- 2. 候補で読み込み判定を見る
- 3. 代表文字を文脈で確認する
- 4. 別名へ保存する
- 5. 再読込して元標本との差を検査する
固有標本で判定欄を埋める
髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本では、見た目の印象ではなくBOMから再読込同値までを順に判定します。対象の名前、開始値、保存先または成果物IDを添えれば、古い結果を今回の結果と取り違えません。
ここで記録するのは『うまくいった気がする』ではなく、BOMと再読込同値の何を見て合格または保留にしたかです。二周目では、未実施の欄は未実施のまま残し、『UTF-8、BOM付きUTF-8、Shift_JISの三標本を判定・別名保存・再読込できる』という結論へ広げて解釈しません。
- BOM:対象と期待状態を先に書き、『判定名だけで本文を見ない』なら未合格として戻し先を示す
- 判定表示:対象と期待状態を先に書き、『変換不能警告のまま上書きする』なら未合格として戻し先を示す
- 代表文字:対象と期待状態を先に書き、『再読込で代表文字が変わる』なら未合格として戻し先を示す
- 別名保存:対象と期待状態を先に書き、『判定名だけで本文を見ない』なら未合格として戻し先を示す
- 再読込同値:対象と期待状態を先に書き、『変換不能警告のまま上書きする』なら未合格として戻し先を示す
『判定名だけで本文を見ない』に当たる状態を最初に切り分ける
このテーマで止めるべき状態は、判定名だけで本文を見ない、または変換不能警告のまま上書きする、または再読込で代表文字が変わるです。三つを一括して『使いにくい』とせず、どの入力、設定、成果物で観察したかを分けます。原因が違えば戻し先も違います。
修正後は三標本の初期バイトを記録するから全項目をやり直す必要はありません。ただし、変更した条件に影響するBOM・判定表示・代表文字・別名保存・再読込同値は再確認します。前回の行を消さず、変更日と新しい成果物を追加すると差分が追えます。
- 停止1:判定名だけで本文を見ない
- 停止2:変換不能警告のまま上書きする
- 停止3:再読込で代表文字が変わる
Rune Studioを候補に加える範囲
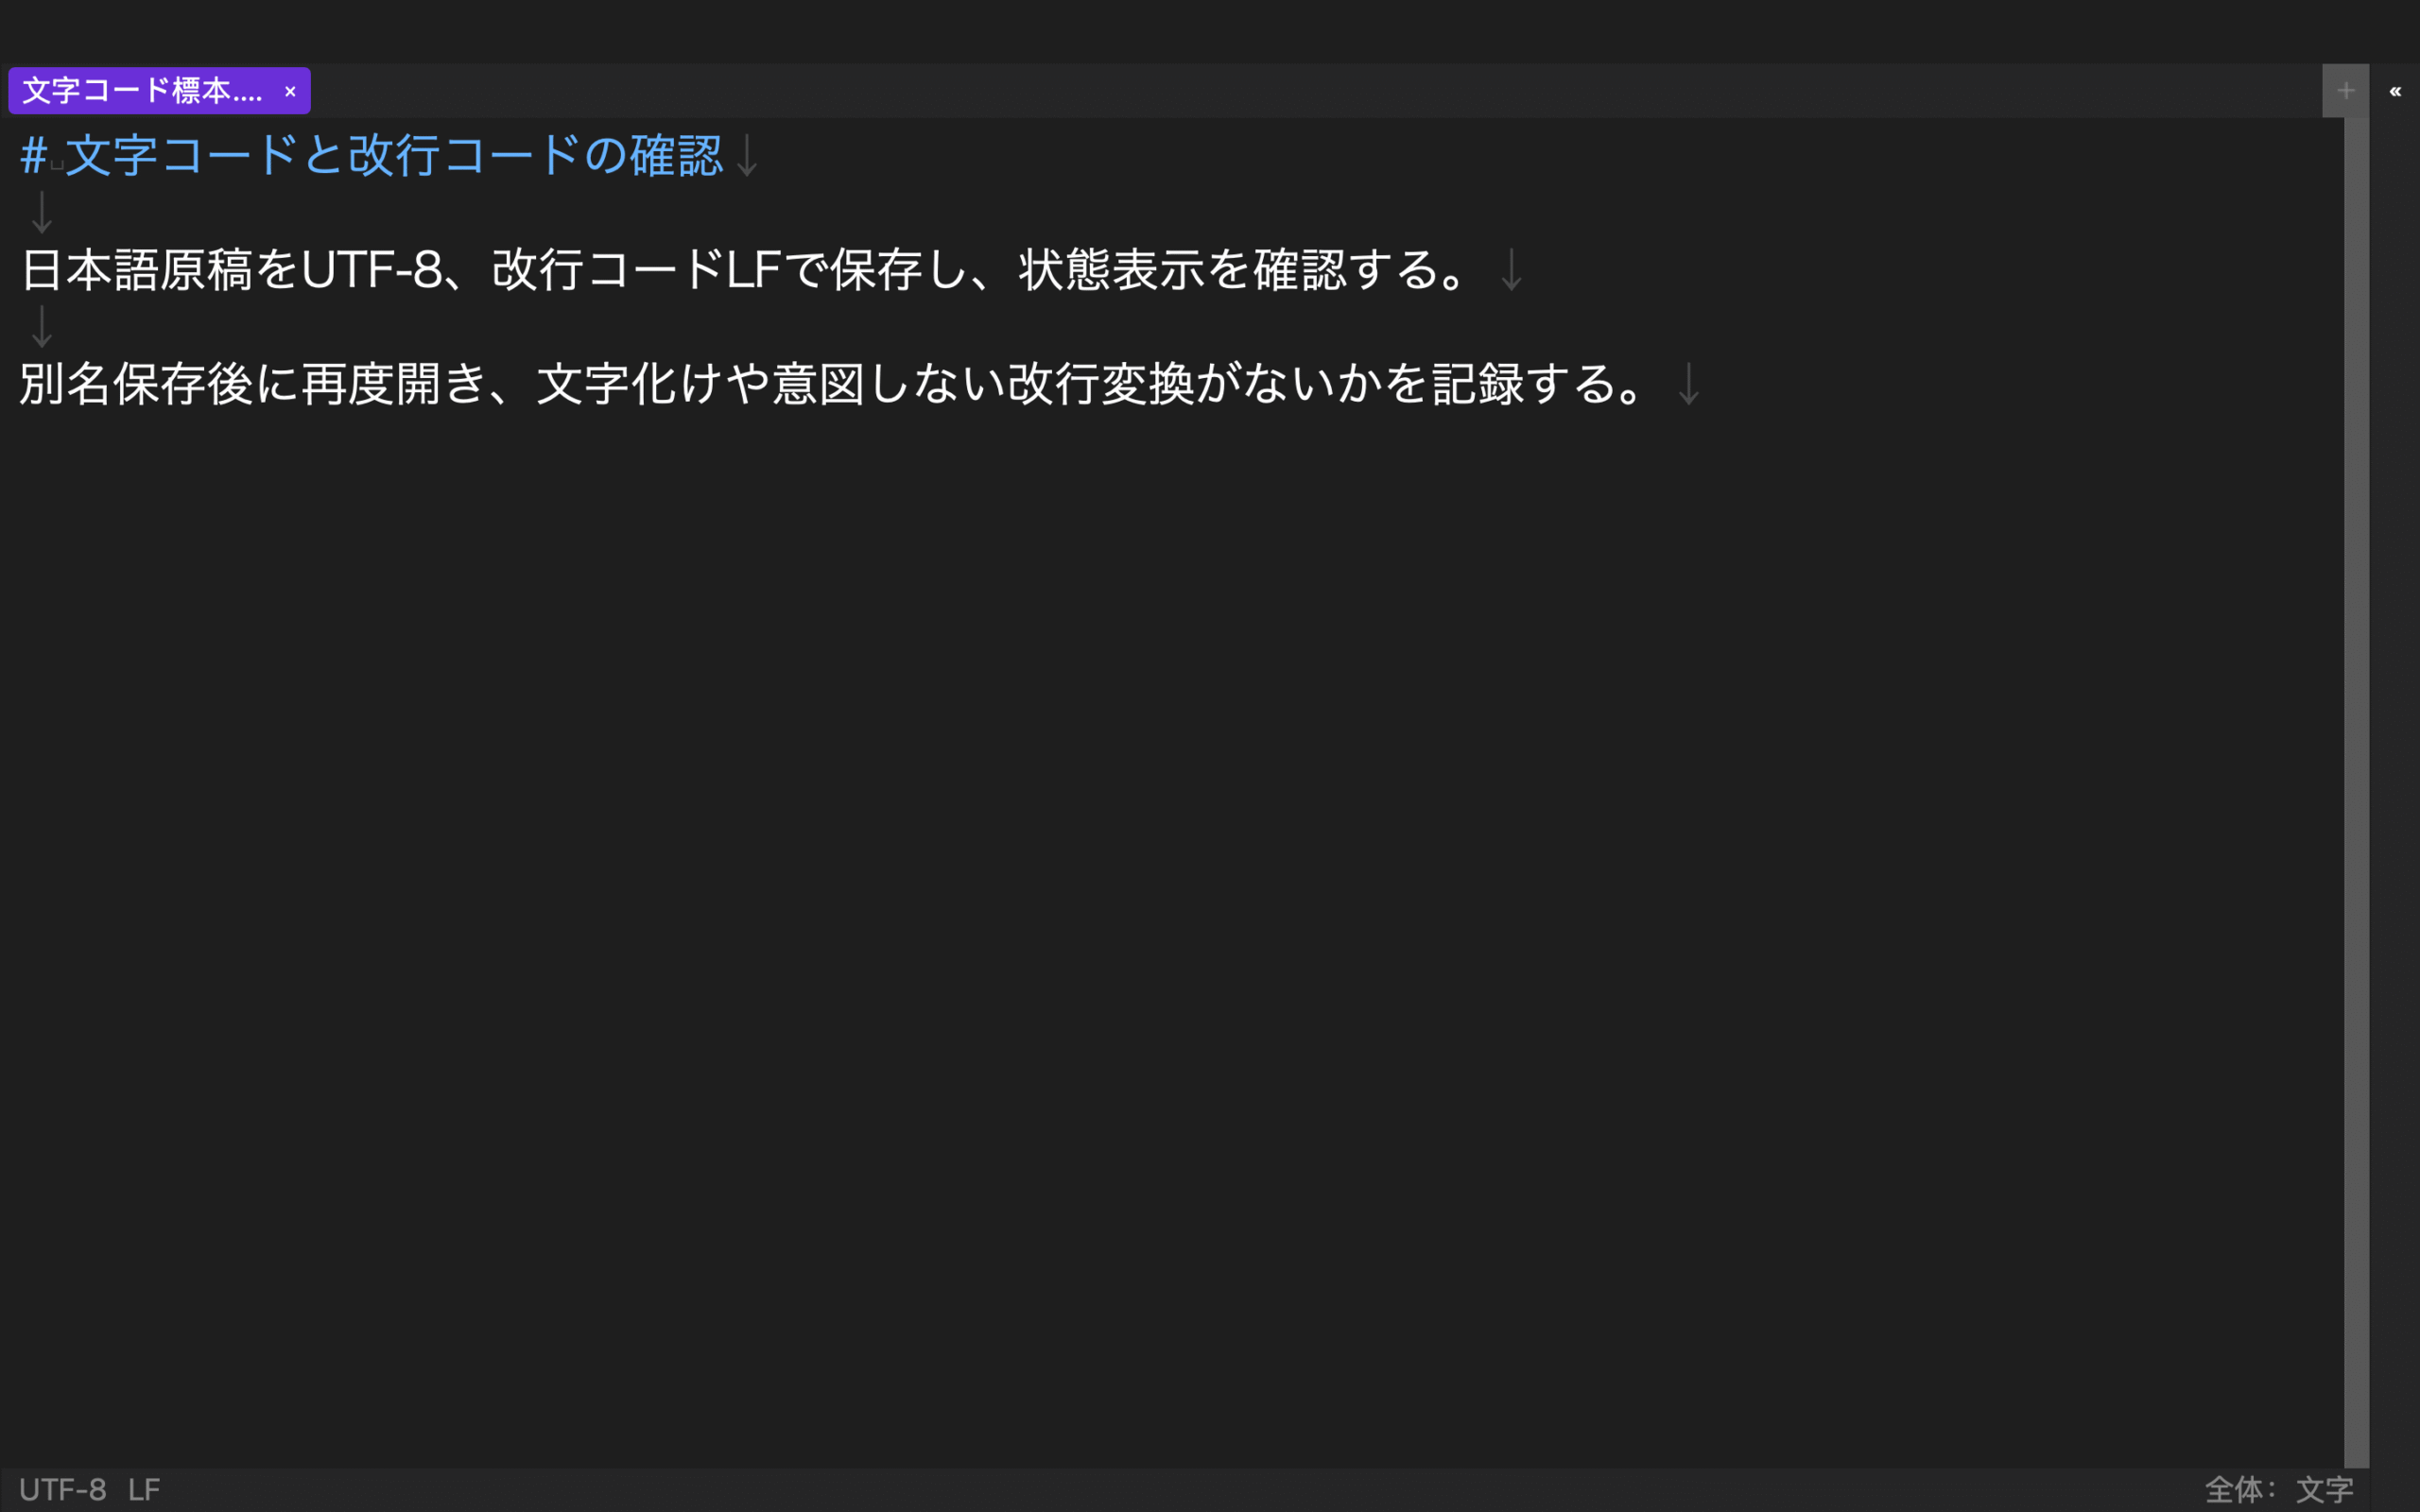
公開機能資料では「主要な日本語文字コードを判定し、変換不能文字を赤く示し、解消まで自動保存を停止する」という機能範囲が確認できます。そのため、主要な日本語文字コードと改行コードを識別し、別名保存後に再読込する用途を一つの制作環境で試したい場合の候補になります。ただし、この説明は公開資料で確認した機能範囲であり、髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本が全項目に合格したという実測結果ではありません。
向くのは、自動判定を開始情報とし、代表文字とバイト境界で確定するという管理を保ちながら、原稿と設定または資料の受け渡しを減らしたい人です。一方、本記事の対象外は『壊れた原稿の復元や全文字コードの完全自動判定は扱わない』です。その範囲や外部サービス側の受理まで必要な場合は、別の道具と出口検査を組み合わせます。
結論:UTF-8の代表四文字とShift_JISの符号化可能文字を別欄に記録する
テキストエディタ 文字コードで持ち帰る結論は、自動判定を開始情報とし、代表文字とバイト境界で確定することです。BOM・判定表示・代表文字・別名保存・再読込同値を別欄にすれば、『UTF-8、BOM付きUTF-8、Shift_JISの三標本を判定・別名保存・再読込できる』へ達したかを、機能数や印象ではなく記録で判断できます。
まずUTF-8の代表四文字とShift_JISの符号化可能文字を別欄に記録する。髙・﨑・①・絵文字を含むUTF-8二標本と、漢字・かな・半角カナだけを含むShift_JIS標本の複製で一周し、『判定名だけで本文を見ない』に当たる状態が起きた地点を残してください。Rune Studioを試す場合も同じ作業票を使い、公開仕様の存在と手元の合格結果を混ぜないことが次の比較を正確にします。
この記事が答えるのは『自動判定を開始情報とし、代表文字とバイト境界で確定する』までです。近接するSTUDIO-521(BOM判別)、STUDIO-168(Macエディタ選定)の中心論点は代替しません。除外範囲は『壊れた原稿の復元や全文字コードの完全自動判定は扱わない』です。製品候補を確認するときは、Rune Studioの製品ページで現行Mac版の範囲を照合してください。